Avec la récente publication des poids ouverts de Mistral Large 4, une question que beaucoup de directions françaises avaient mise de côté revient sur la table : faut-il faire tourner un LLM auto-hébergé sur sa propre infrastructure, ou continuer à appeler les API des modèles frontières comme Claude, GPT ou Gemini ? La réponse est rarement « l'un ou l'autre ». Elle dépend de vos données, de vos volumes, de votre équipe et de votre exposition réglementaire. Ce guide vous donne une grille de décision applicable dès ce trimestre, sans effet de mode.
Ce que change l'ouverture des poids de Mistral Large 4
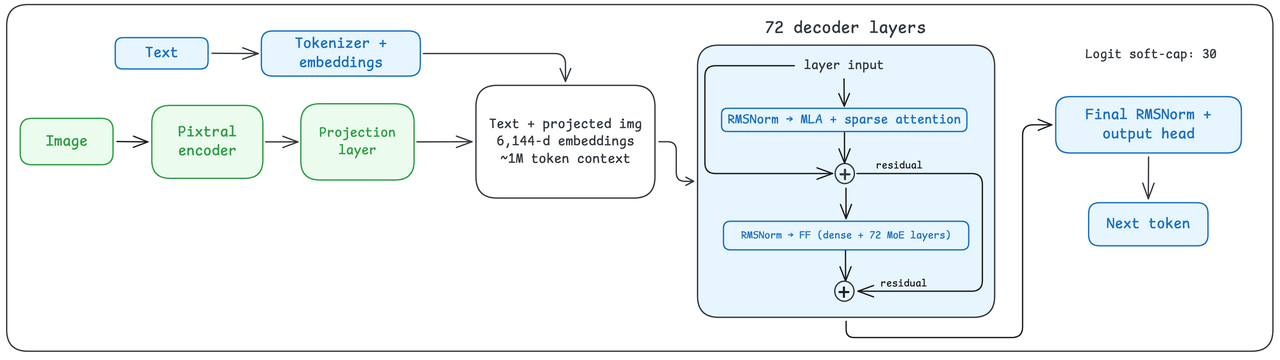
D'après l'annonce de Mistral (en anglais), Mistral Large 4 est un modèle nativement multimodal d'environ mille milliards de paramètres, désormais téléchargeable sur Hugging Face sous la licence Mistral Ecosystem Open-Weight, une licence MIT modifiée. L'usage, la modification, le fine-tuning et l'exploitation commerciale sont autorisés ; les entreprises qui vendent le modèle lui-même en tant que service hébergé doivent obtenir une licence commerciale distincte.
Trois points comptent pour une décision business :
- C'est un modèle Mixture-of-Experts : seule une partie des paramètres est sollicitée à chaque token, ce qui limite le coût d'inférence par rapport à sa taille affichée. La page modèles de Mistral (en anglais) indique une fenêtre de contexte d'un million de tokens.
- Ce n'est pas un modèle pour PC portable : le blog de lancement Hugging Face (en anglais) cite 8 GPU NVIDIA H200 pour le servir en FP8 sur ses Inference Endpoints. C'est du matériel de datacenter, pas un serveur oublié au sous-sol.
- Le même modèle existe aussi en API : Mistral affiche un tarif de 0,70 $ par million de tokens en entrée et 2,10 $ par million de tokens en sortie. Vous pouvez démarrer en API puis passer à votre propre hébergement sans changer de modèle.
C'est ce dernier point qui change la donne. Pour la première fois, un grand modèle européen de cette catégorie est disponible à la fois en API managée et sous forme de poids que vous maîtrisez. La question « auto-hébergé ou frontière ? » cesse d'être un débat de principe pour devenir un calcul de coûts et de risques.
LLM auto-hébergé ou API : les vrais compromis
Avant de comparer des benchmarks, comparez les modèles opérationnels. Voici ce que chaque option implique concrètement pour une entreprise B2B française.
Maîtrise des données : un modèle auto-hébergé garde prompts et documents dans votre périmètre. Une API de modèle frontière les envoie à un fournisseur, selon ses conditions contractuelles et son accord de sous-traitance.
Plafond de qualité : les meilleurs modèles frontières propriétaires restent souvent devant sur le raisonnement complexe, le code et les tâches d'agents IA. Les modèles open source et à poids ouverts ont largement rattrapé leur retard sur le travail courant : résumer, classer, extraire, rédiger. Testez sur vos propres tâches plutôt que de vous fier à un classement.
Profil de coût : une API est un coût purement variable, faible à petit volume et prévisible par requête. L'auto-hébergement est surtout un coût fixe (GPU, hébergement, temps d'ingénierie) qui ne se rentabilise qu'à volume élevé et régulier.
Compétences nécessaires : une API demande des compétences d'intégration. L'auto-hébergement exige des équipes capables d'exploiter une pile de service comme vLLM (en anglais), qui expose une API compatible OpenAI, ainsi que la supervision, la montée en charge, les correctifs de sécurité et les mises à niveau de modèle.
Rythme d'innovation : avec une API, vous profitez des nouvelles versions dès leur sortie. En auto-hébergement, vous choisissez quand migrer : c'est un gage de stabilité, mais vous risquez de prendre du retard.
Règle simple : si vos GPU restent inactifs la majeure partie de la journée, l'API est presque toujours moins chère. L'auto-hébergement devient rationnel quand les volumes sont élevés et constants, quand les données ne peuvent pas sortir de votre périmètre, ou les deux.
RGPD et AI Act : ce qui s'applique vraiment à vous
Les arguments de souveraineté mélangent souvent deux réglementations distinctes. Séparez-les.
Le RGPD porte sur les données personnelles que vous envoyez. Les questions-réponses de la CNIL sur l'utilisation d'un système d'IA générative indiquent qu'un déploiement sur site est généralement à privilégier pour des données personnelles ou sensibles, car il limite le risque d'accès par un tiers. Un hébergement cloud reste possible avec un contrat de sous-traitance qui précise les rôles et les accès. Avec une API, la CNIL recommande de limiter les données personnelles transmises, d'encadrer tout transfert hors de l'UE, d'impliquer votre DPO et d'envisager une analyse d'impact relative à la protection des données (AIPD).
L'AI Act vise surtout les fournisseurs de modèles, pas vous. La FAQ de la Commission sur les obligations des modèles d'IA à usage général (en anglais) précise que ces obligations s'appliquent depuis le 2 août 2025, avec un contrôle complet, amendes comprises, à partir du 2 août 2026. Une entreprise qui fait du fine-tuning ou modifie un modèle ne devient « fournisseur » que dans des cas exceptionnels, lorsque la modification mobilise plus d'un tiers de la puissance de calcul de l'entraînement initial. Pour la plupart des entreprises qui exploitent ou ajustent légèrement un modèle à poids ouverts, les obligations de fournisseur restent chez le laboratoire d'origine.
En pratique, un LLM auto-hébergé simplifie le volet RGPD (pas de transfert, pas de sous-traitant externe pour les prompts), mais ne supprime ni vos obligations de déployeur, ni le besoin de contrôle des accès, de journalisation et d'une finalité claire pour chaque cas d'usage.
Grille de décision : choisir l'auto-hébergement si… choisir une API si…
Choisissez un modèle à poids ouverts auto-hébergé ou hébergé dans l'UE si :
- Vos cas d'usage traitent des données personnelles sensibles, des données de santé ou des secrets d'affaires que votre service juridique refuse de voir sortir du périmètre.
- Vous avez des volumes élevés et réguliers, par exemple la classification nocturne de documents ou de tickets.
- Vous devez figer une version de modèle pendant des mois pour des raisons d'audit ou de reproductibilité.
- Vous exploitez déjà une infrastructure GPU ou MLOps, ou disposez d'un partenaire cloud qui le fait pour vous dans l'UE.
Choisissez l'API d'un modèle frontière si :
- Vous explorez encore vos cas d'usage et vos volumes sont faibles ou imprévisibles.
- Vos tâches exigent le meilleur niveau disponible en raisonnement, en code ou en agents IA multi-étapes.
- Vous n'avez pas l'équipe pour exploiter et sécuriser une pile d'inférence en continu.
- Les données concernées peuvent être minimisées ou pseudonymisées avant de quitter vos systèmes.
Choisissez une architecture hybride si vous vous reconnaissez dans les deux listes. C'est le cas de la plupart des ETI : un routeur envoie les tâches sensibles ou à fort volume vers un modèle à poids ouverts que vous maîtrisez, et les tâches complexes à faible volume vers une API frontière. Comme vLLM et la plupart des fournisseurs parlent la même API de type OpenAI, basculer un workflow de l'un à l'autre peut se limiter à un changement de configuration plutôt qu'à une réécriture.
Que faire maintenant : un plan en 6 étapes
- Listez vos cinq principaux cas d'usage d'IA générative en entreprise et classez les données que chacun manipule : publiques, internes, personnelles, sensibles.
- Estimez les volumes mensuels en requêtes et en tokens pour chaque cas d'usage. Sans cela, toute comparaison de coûts relève de la devinette.
- Constituez un petit jeu d'évaluation de 30 à 50 exemples réels par cas d'usage, avec les réponses attendues, et notez deux ou trois modèles candidats.
- Chiffrez les deux options : coût de l'API à vos volumes face à l'hébergement GPU et au temps d'ingénierie d'un LLM auto-hébergé, supervision et mises à niveau comprises.
- Impliquez votre DPO dès le départ : documentez les flux de données, les sous-traitants et les transferts, et décidez si une AIPD est nécessaire.
- Démarrez par un pilote en API, en visant la portabilité : gardez prompts, jeux d'évaluation et code d'intégration indépendants du modèle pour pouvoir basculer une charge vers l'auto-hébergement quand les chiffres le justifient.
Pour mener cet exercice de façon structurée, notre audit IA cartographie vos cas d'usage et vos contraintes de données, et notre accompagnement stratégie et feuille de route IA les transforme en plan de déploiement séquencé. Si vous êtes prêts à construire, découvrez nos implémentations IA. Vous pouvez aussi lire comment connecter Claude à un CRM via MCP ou notre analyse de l'IA agentique pour les implémentations Salesforce.
Conclusion
L'ouverture des poids d'un modèle de cette taille par un laboratoire européen change la discussion, pas la méthode. Partez de vos données et de vos volumes, testez les modèles sur vos propres tâches et gardez une architecture portable. Pour la plupart des entreprises B2B françaises, la bonne réponse en 2026 n'est ni « auto-hébergé » ni « frontière », mais un mix assumé des deux.